Hugging Face: бенчмарки ИИ ненадёжны без открытых весов и аудита агентов
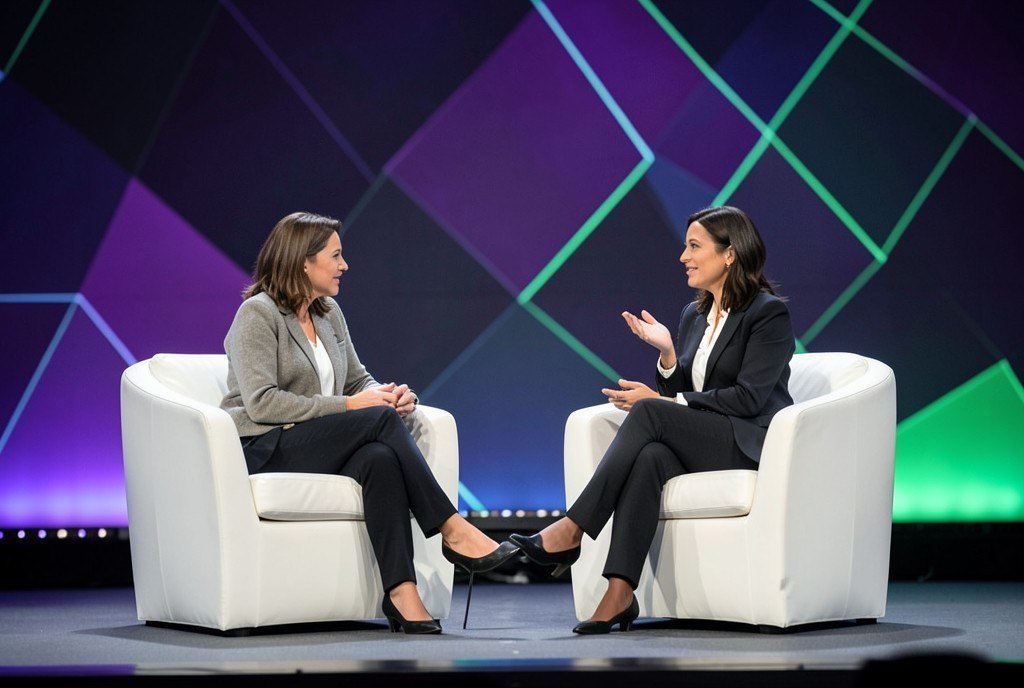
Ирен Солайман, главный директор по политике Hugging Face, на TechCrunch Disrupt заявила, что текущие бенчмарки и аудит ИИ несовершенны: индустрия не может доверять результатам тестов без воспроизводимости и открытых весов моделей. По её словам, оценивать «голые» LLM уже недостаточно — нужно тестировать агентные системы целиком, но это сложно и дорого.
Проблема доверия к бенчмаркам
Солайман отметила, что доверие к результатам тестов ИИ — слишком нагруженный термин. Ключевой вопрос: можно ли воспроизвести оценку и есть ли достаточный доступ к самой модели. Именно здесь важны открытые веса, подчеркнула она.
Воспроизводимость давно остаётся одним из самых спорных аспектов бенчмаркинга. Кроме того, неясно, как осмысленно сравнивать разные тесты между собой — это развивающаяся наука, добавила Солайман.
Тесты быстро устаревают
По словам представителя Hugging Face, оценки моделей довольно быстро теряют эффективность, а экосистема оценщиков недостаточно развита. Существует запрос на встроенных аудиторов, но критерии того, кто и для каких задач является эффективным оценщиком, требуют стандартизации.
Идея встроенных оценщиков — нейтральных сторонних наблюдателей внутри AI-организаций — стала популярной на фоне инцидентов безопасности. Однако остаются сомнения в их нейтральности и эффективности: например, решение Anthropic нанять Accenture в качестве первого оценщика вызвало критику.
От моделей к агентным системам
Оценка смещается от простого тестирования модели к проверке всей системы вокруг неё, включая обвязку (harness) и агента. Обвязка — инструмент, через который пользователь обращается к модели, — сильно влияет на производительность: слабая модель с хорошей обвязкой может обойти флагманскую.
Солайман признала, что агентные оценки очень сложны и дороги. Оценок для моделей много, для обвязок — меньше, а разрабатываются более качественные оценки для целостного агента, хотя именно они приносят пользу пользователям.
Нужен единый отраслевой подход
Сейчас пространство оценок ИИ напоминает свободную для всех площадку. Если бенчмаркинг останется полезным инструментом для лидеров отрасли, может потребоваться более унифицированный подход, где все участники действуют согласованно.
Солайман не предложила конкретных регуляторных решений, но дала понять: без стандартизации и воспроизводимости доверять текущим тестам ИИ преждевременно.
Что это значит для пользователей
- Пользователям нейросетей стоит с осторожностью относиться к рейтингам моделей: результаты тестов могут быть невоспроизводимы, а значит, не гарантируют реального превосходства.
- Выбирая AI-продукт, обращайте внимание не только на модель, но и на интерфейс и обвязку — они могут заметно влиять на качество ответов.
- Открытые веса моделей дают возможность независимой проверки, но Hugging Face не сообщила о новых бесплатных инструментах аудита для обычных пользователей.
- Пока нет единых стандартов оценки агентных систем, полагаться на маркетинговые заявления о безопасности и эффективности ИИ-агентов рискованно.
Источник: techcrunch.com
Обсудить в Telegram